いま市場に出回っているバラ積みピッキング製品のカタログには、ほぼ例外なく「AI」という言葉が並んでいます。しかし、そのAIが実際に何をしているのか、どのように学習させたのか、そしてそれが立ち上げ期間や長期的な保守にどう影響するのかまで説明されていることは、ほとんどありません。この情報不足が、システムを技術的な中身で比較することを必要以上に難しくしています。
本記事では、バラ積みピッキングのAIモデルを学習させる代表的な3つの手法について、それぞれ何を行うのか、どのような用途に向くのか、そして「柔軟に使えるシステム」と「一つの運用方法に縛られるシステム」を分けるものは何かを、実務の観点から整理します。
バラ積みピッキングシステム全体の考え方と、成立条件については、Eurekaのエンジニア向け実践ガイドで基礎から解説しています。最新のピッキングシステムの内部で機械学習が実際に何をしているのかをより深く知りたい方は、関連記事のバラ積みピッキングにおける機械学習から読み進めることをおすすめします。
AIは実際に何をしているのか
ビジョンガイド型のバラ積みピッキングシステムは、性質の異なる2つの課題を解く必要があります。
1つめはビジョンです。ワークがどこにあり、どの姿勢を取っていて、ロボットがどこを掴む(あるいは吸着する)べきかを求めます。
2つめはモーションです。ワークをピックして目的地に置くまでの動作を計画し、実行します。
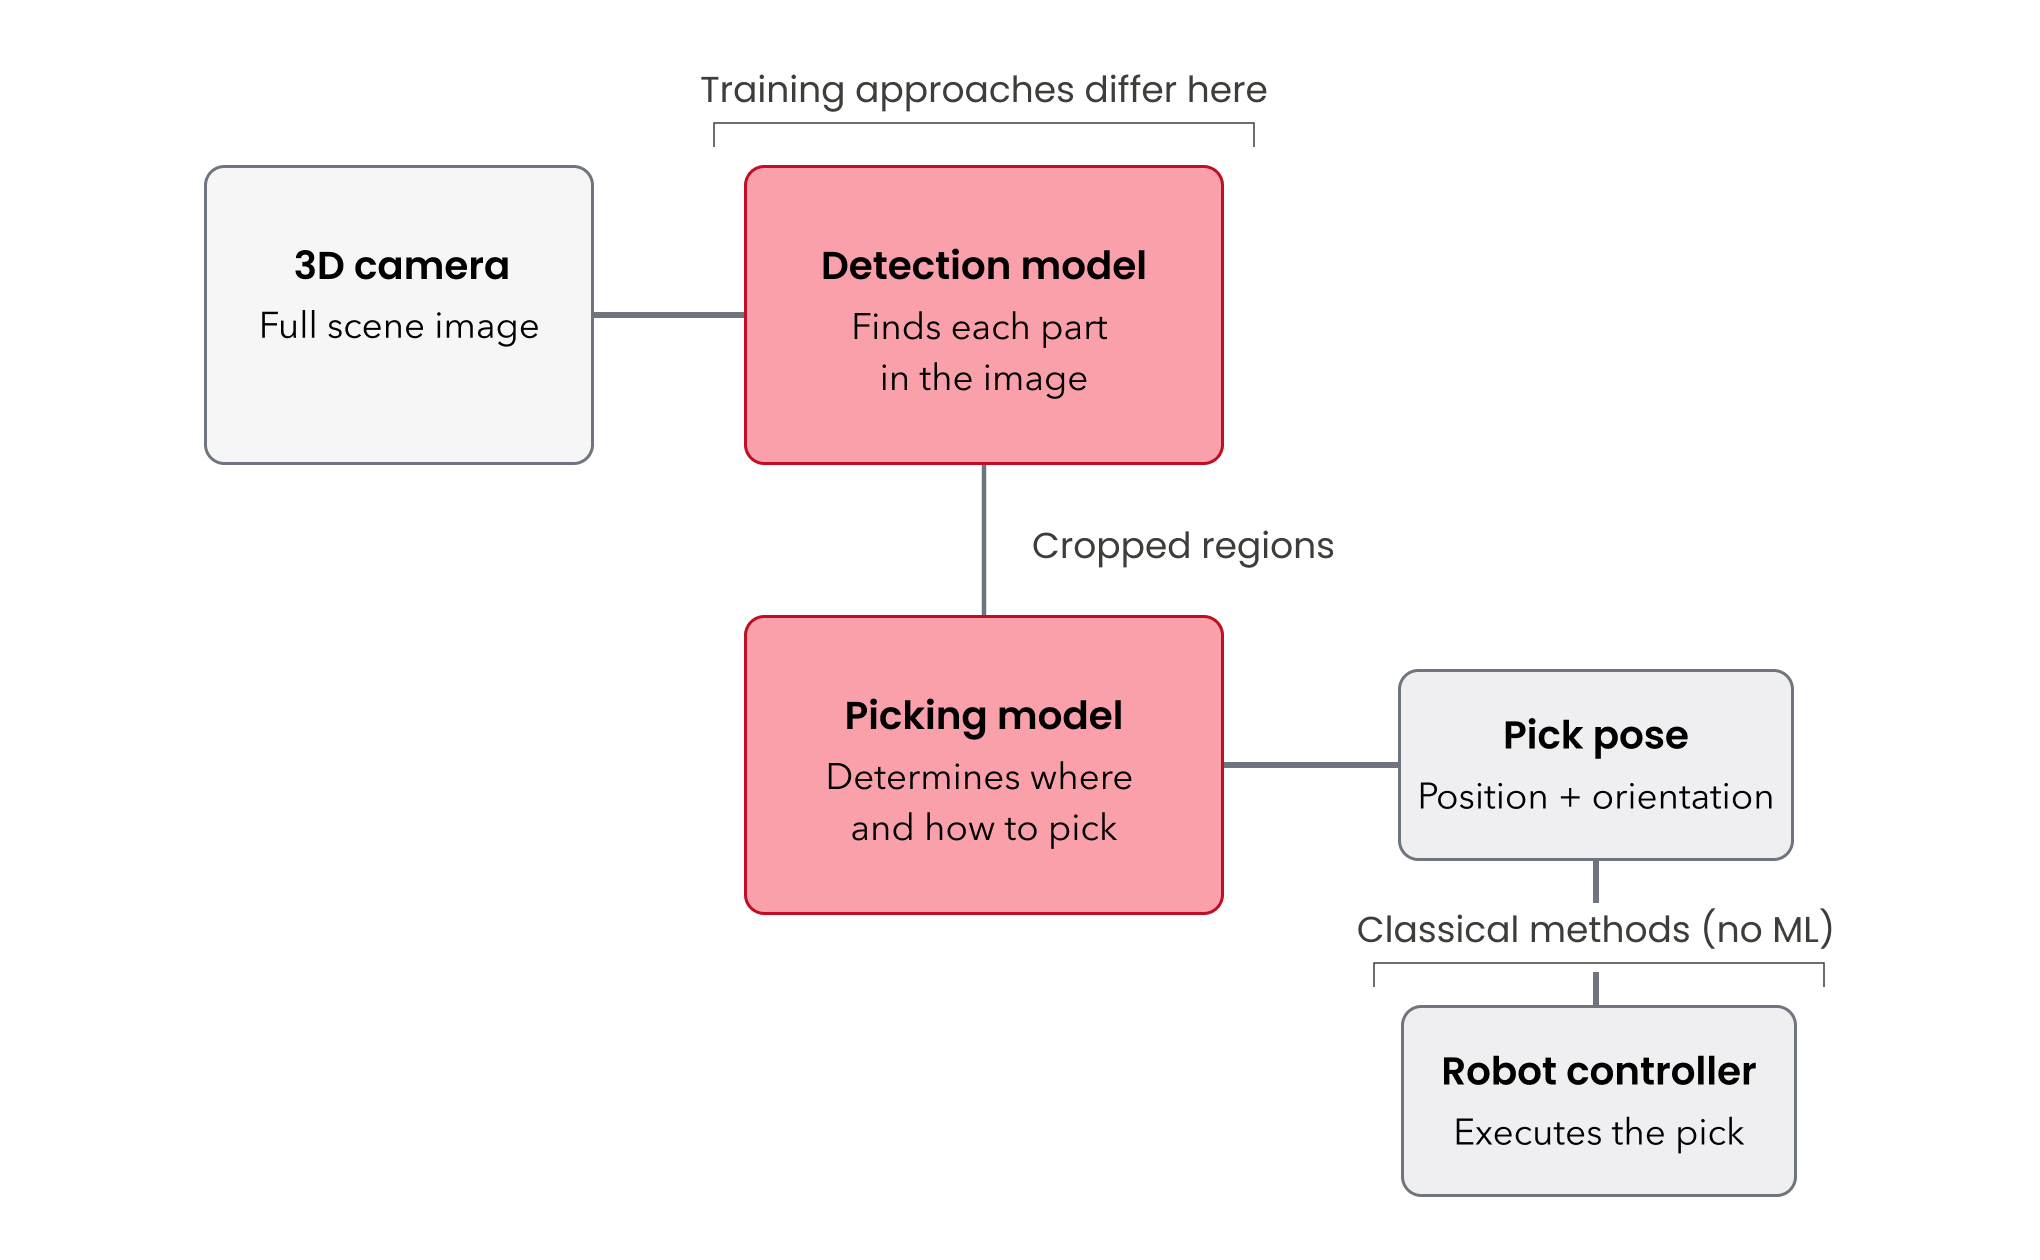
機械学習が主に力を発揮するのは、ビジョン側です。モーション計画については、数十年にわたり産業用ロボットを動かしてきた古典的な手法のほうが、この領域では依然として高い信頼性と効率性を示します。この違いは、ベンダーの主張を評価するうえで重要です。「AI搭載」と説明されるシステムでも、機械学習をビジョンだけに使っている場合、モーションだけに使っている場合、その両方に使っている場合があり、性能と保守性への影響は大きく異なります。
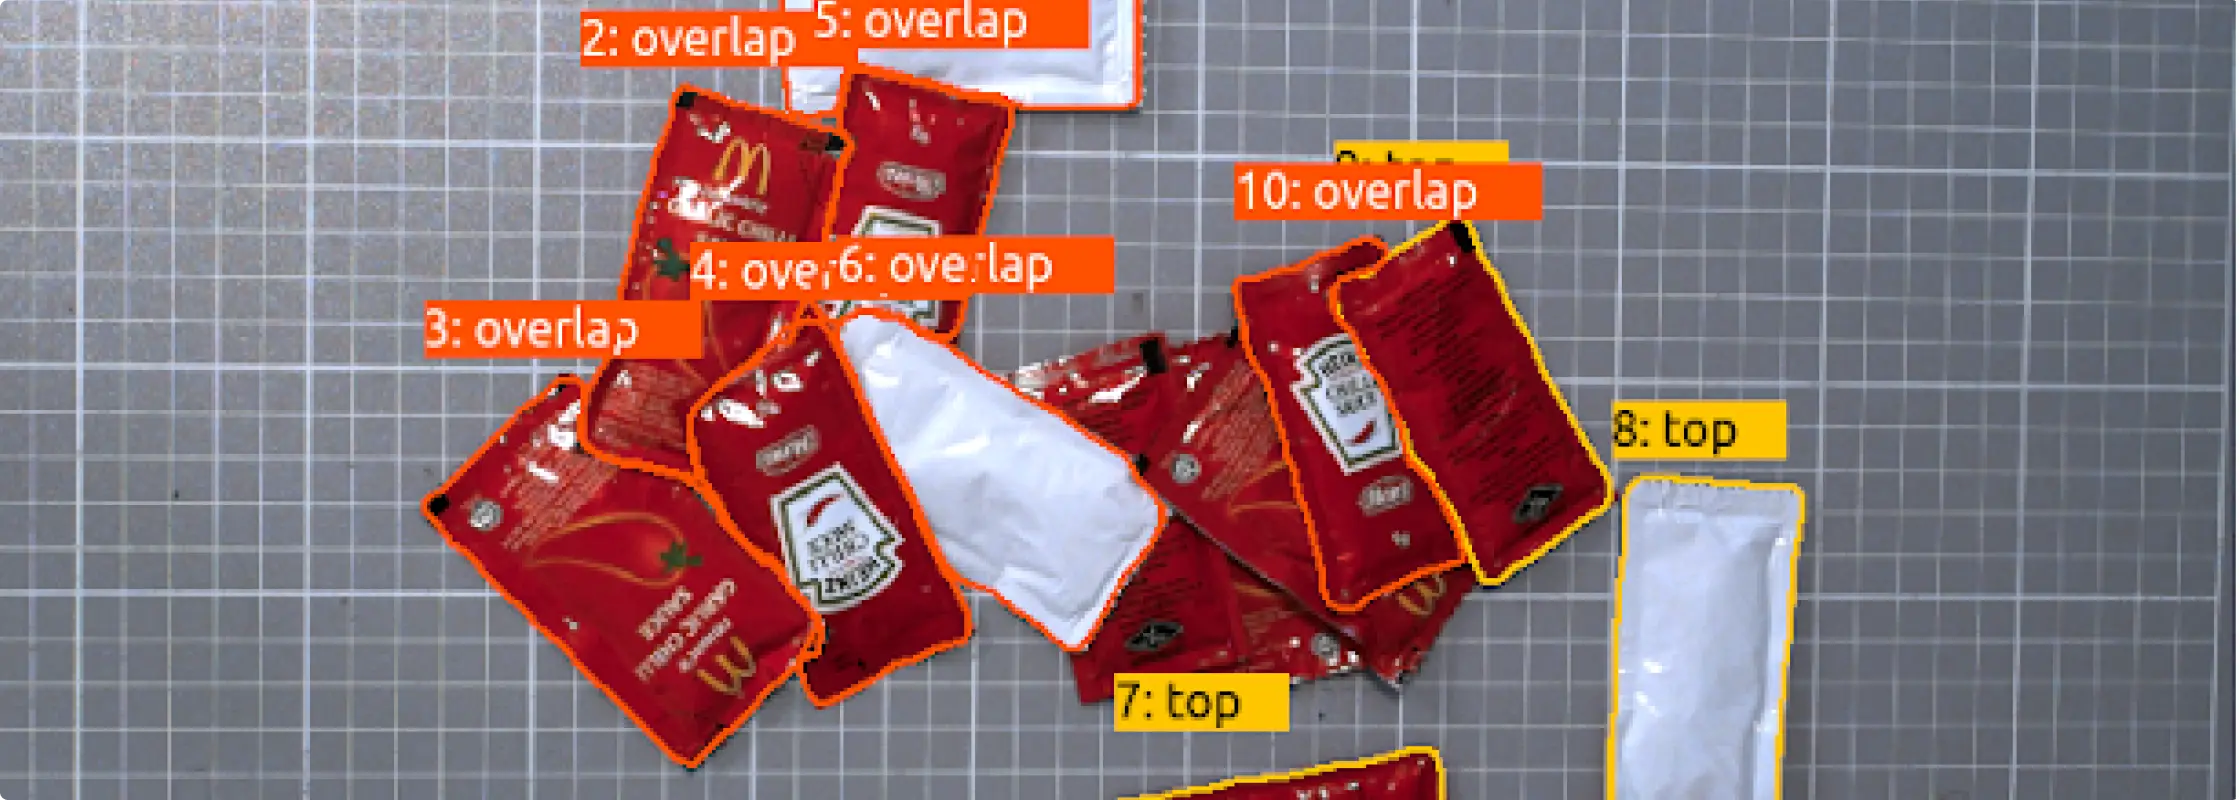
2つのモデルが順に動く。 ビジョン側では、最新のシステムの多くが2つのAIモデルを直列で動かしています。1つめのモデルは、3Dカメラが取得した画像から個々のワークを検出し、位置を特定します。2つめのモデルは、各ワークをどのようにピックするか(ロボットが接近すべき位置と方向)を決定します。以下で説明する3つの学習手法は、この2つのモデル用のデータをどう生成するかという点で主に異なります。
学習の3つの手法
すべてのワークに同じ学習手法が必要なわけではありません。良いベンダーであれば、その用途にどの手法が適しており、それはなぜかを説明できるはずです。
バラ積みピッキング業界には、CADベースの手法しか持たないベンダーも存在します。つまり、顧客のCADデータがなければ何も始められないということです。
Eurekaは3つの手法を用意しています。学習が一切不要な事前学習済みのマスターレスモデル、CADデータを必要としないアノテーションベースのワークフロー、そしてCADベースの手法です。
3つすべてを持っているということは、すべての案件を同じパイプラインに押し込むのではなく、用途に合わせて手法を選べるということです。それぞれを見ていきましょう。
1. マスターレス(登録不要)ピッキング:学習は不要
どういう手法か。 産業部品、消費財、包装材など幅広いカテゴリの数百万点のオブジェクトで事前学習された、2つの基盤AIモデル(検出モデル+ピッキングモデル)です。対象のワークを一度も見たことがなくても、顧客やインテグレータ側での設定なしに、一般的な物体を認識してピックできます。「登録不要(registration-free)」と呼ばれるのはこのためです。
向いている用途。 形状が単純で識別しやすいワーク。ワークを異なる排出ビンに振り分けるものの、正確な置き方までは求められない仕分け用途。入ってくるワークが予測できない多品種の現場。
不得意な領域。 マスターレスモデルは、ワークを正確に置くことはできません。特定の向きに揃えて置く必要がある場合や、治具に精密に着座させる必要がある用途では、CADベースまたはアノテーションベースの手法が必要になります。
2. CADベース学習:3Dモデルから合成データを生成する
どういう手法か。 ワークのCADデータから合成画像を自動生成し、手作業をほとんど介さずに大量のアノテーション済みデータセットを作る学習手法です。
実際の進め方。 シミュレーションツールが3D CADモデルを読み込み、仮想のコンテナに仮想のワークを投入します。ワーク数、照明条件、背景のテクスチャ、カメラノイズを変化させながら、現実に近いレンダリング画像を数百枚生成します。
シミュレーション空間内では各ワークの位置が正確に分かっているため、アノテーションデータも自動で生成されます。人がワークを一つずつ手で囲む必要はありません。エンジニアが手を動かすのは主にシミュレーション条件の設定です。コンテナ内のワーク数、想定する照明条件の幅、加えるノイズ量などを決めていきます。
向いている用途。 精度の高いCADモデルが用意できるのであれば、ピッキングモデルの学習手法として最も信頼性が高く、工数も少なく済む傾向があります。
不得意な領域。 問題になるのは2つのケースです。1つめは、正確なCADモデルが存在しない場合です。古い部品、ばらつきが記録されていない購入品、あるいは図面寸法と現物寸法がずれている機械加工品などが該当します。
2つめは、合成レンダリング画像と実際のカメラ画像の差が大きすぎる場合です。レンダリング画像がきれいすぎる一方で、実際の画像には表面のノイズ、油の付着、照明のばらつきが写り込んでいる案件では、学習したモデルが現場で性能を発揮できないことがあります。シミュレーションがカメラの見ている世界を忠実に再現できなければ、そのデータで学習したモデルもうまく転用できません。
3. アノテーションベース学習:実画像からモデルに教え込む
どういう手法か。 実際のワークをカメラで撮影した画像をそのまま使い、人がアノテーションを付けることで、何を見るべきかをモデルに教える学習手法です。
実際の進め方。 エンジニアが、生産条件を代表するようなコンテナ内のワーク画像を30〜50枚撮影し、EurekaのML Studioでアノテーションを付けます。アノテーション作業では、スマートセグメンテーション機能を使って各ワークを囲みます。1回クリックするとワーク同士の境界が自動でトレースされるので、囲んだ領域にラベルを付けていきます。ピッキングモデルの学習も必要で、各ワークについて、ロボットがどの方向から接近してどうピックするかをエンジニアがアノテーションします。
アノテーション作業の実情。 難しい作業ではありません。ただし時間がかかり、アノテーションの質がそのままモデルの質を決めます。誰も好んでやりたがらない作業ですが、土台になる部分です。ここで手を抜くと、後からピック信頼性という形で表面化します。
向いている用途。 使えるCADデータがないワーク。表面の質感、反射、汚れ、色といった特性が合成レンダリングでは再現しにくいワーク。旧世代の部品や購入品など、現物が3Dモデルと無視できない差を持つケース全般です。
どの手法を選ぶか
厳密な判断フローがあるわけではありません。実際には技術的な判断が入りますが、Eurekaのチームは最も単純で成立しそうな手法から始め、用途が要求する場合にのみ段階を上げていくことが多いです。標準的な進め方は次のとおりです。
- まずマスターレス(登録不要)を試す。
- 正確な置き方が必要な場合や、形状が複雑で良質なCADがある場合は、CADベース学習に移る。
- CADデータがない場合や、実環境の撮像条件をシミュレーションで再現しにくい場合は、実画像を使ったアノテーションベース学習を用いる。
| マスターレス | CADベース | アノテーションベース | |
|---|---|---|---|
| 仕組み | 事前学習済みの基盤モデル | 3Dモデルからの合成データ | 実カメラ画像で学習 |
| 学習工数 | 不要 | 少ない | 中程度 |
| 最初のピックまで | 数時間 | 1〜2日 | 1〜2日 |
| CADデータの要否 | 不要 | 必要 | 不要 |
| ワークの複雑さ | 単純で識別しやすい形状 | 中程度〜複雑 | 中程度〜複雑 |
| 置き精度 | バラ置き | 位置・姿勢を揃えた精密配置 | 位置・姿勢を揃えた精密配置 |
開梱から最初のピックまで、システム全体をどう立ち上げるかについては、Eurekaのセットアップ解説で一連の流れを紹介しています。ベンダーの評価、商流モデル、総保有コストの考え方については、バイヤーズガイドで市場全体を俯瞰しています。
--
ユーレカロボティクスは、産業自動化向けのビジョンガイド型バラ積みピッキングシステムを開発しています。Pratt & Whitney、Coherent、住友ベークライト、丸和電機化学をはじめとするお客様の現場で、累計3,000万回以上のピックを本番稼働で実行しています。